AI ·
NVIDIA Nemotron 3.5 – nowe możliwości lokalnej sztucznej inteligencji dla firm
NVIDIA rozwija rodzinę modeli Nemotron, oferując przedsiębiorstwom nowe możliwości tworzenia zaawansowanych agentów AI. Modele Nemotron 3.5 mogą być wykorzystywane do analizy dokumentów, automatyzacji procesów i budowania inteligentnych asystentów, również w lokalnej infrastrukturze IT.
Źródło: NVIDIA Blog
NVIDIA rozwija rodzinę modeli Nemotron, oferując przedsiębiorstwom nowe możliwości tworzenia zaawansowanych agentów AI. Modele Nemotron 3.5 mogą być wykorzystywane do analizy dokumentów, automatyzacji procesów i budowania inteligentnych asystentów, również w lokalnej infrastrukturze IT.
Nowa generacja modeli AI
NVIDIA Nemotron 3.5 to rodzina otwartych modeli ogłoszona w październiku 2026 roku. Producent opisuje ją jako narzędzie do wyspecjalizowanych agentów: rozumowania, pracy z dokumentami i obrazem oraz automatyzacji zadań.
W oficjalnych materiałach wyróżnione są trzy kierunki:
- Nemotron 3.5 Super VL 120B-A12B — model multimodalny (tekst, obrazy i wideo na wejściu, tekst na wyjściu). Ma 120 mld parametrów ogółem i uruchamia 12 mld na token. Karta modelu podaje kontekst do 1 mln tokenów. Wagi BF16 służą do dostosowania modelu, a ich wdrożenie NVIDIA opisuje dla układów 4× H100 lub 2× GB200. Osobne wydanie NVFP4 jest już wskazane także dla jednego DGX Spark — do tekstu i obrazu, według receptury vLLM z karty modelu.
- Nemotron 3.5 Bolt 74B-A9B 24GB — model skompresowany z Super VL, przeznaczony do codziennych zadań agentowych. Ma 74 mld parametrów (9 mld aktywnych), natywną kwantyzację około 2 bitów i ma mieścić się w 24 GB pamięci. Kontekst według karty: do 256 tys. tokenów. Wejście obejmuje tekst, obrazy i wideo.
- Nemotron 3.5 Bolt E4B 4GB — mniejszy model językowy, opublikowany 23 października 2026. NVIDIA rozwija go na bazie Gemma 4 E4B z myślą o szybkich asystentach głosowych i urządzeniach. To model tekstowy: około 8 mld parametrów, z czego 4 mld efektywnych. Wariant 4 GB to kwantyzacja Q4_K_M pod llama.cpp; osobna publikacja BF16 jest przewidziana pod vLLM.
Karty modeli oznaczają te wydania jako gotowe do użytku komercyjnego i niekomercyjnego na licencji OpenMDW-1.1. Bolt E4B jest dodatkowo oparty na Gemma 4, którego licencja bazowa to Apache 2.0. Przed wdrożeniem produkcyjnym warto sprawdzić aktualną kartę konkretnego wydania — nazwa rodziny nie oznacza, że każdy wariant ma te same wymagania.
Lokalna infrastruktura AI może być kompaktowa: jeden serwer w szafie albo system biurkowy, bez przenoszenia dokumentów do chmury publicznej.
Lokalne AI na NVIDIA GB10
DGX Spark to kompaktowy system biurkowy NVIDIA oparty na układzie GB10. Dokumentacja vLLM opisuje go jako maszynę do lokalnej inferencji, ze współdzieloną pulą pamięci 128 GB dla systemu operacyjnego, wag modelu i pamięci podręcznej.
NVIDIA wprost wskazuje warianty Bolt jako modele do pracy lokalnej na RTX Spark i DGX Spark. Bolt 74B-A9B 24GB ma obsługiwać zadania agentowe obok innych aplikacji, w budżecie około 24 GB. Bolt E4B jest pozycjonowany pod szybką konwersację na GeForce RTX, Jetson oraz RTX Spark i DGX Spark. Karta tego modelu wymienia DGX Spark także wśród sprzętu testowego.
Do podłączenia aplikacji firmowych służy API. vLLM dokumentuje na DGX Spark serwer zgodny z interfejsem OpenAI. Część modeli jest też w katalogu NVIDIA na build.nvidia.com — opublikowany jest tam między innymi Bolt E4B. Zgodność konkretnego wydania, formatu kwantyzacji i długości kontekstu trzeba wziąć z aktualnej receptury. Pełna precyzja BF16 Super VL nie jest opisana jako wdrożenie na pojedynczym GB10; do takiego scenariusza karta modelu kieruje wydanie NVFP4.
Co to oznacza dla przedsiębiorstw?
Lokalny model może wspierać:
- Analizę wewnętrznych dokumentów i baz wiedzy.
- Budowę systemów RAG, w których zapytanie zostaje w infrastrukturze firmy.
- Automatyzację zadań przy użyciu agentów AI.
- Inteligentne wyszukiwanie informacji w materiałach organizacji.
- Integrację AI z aplikacjami przez lokalne API.
Przetwarzanie na własnym sprzęcie ułatwia decyzję, gdzie leżą dane i kto ma do nich dostęp. Nie zastępuje polityki bezpieczeństwa, kontroli uprawnień ani przeglądu licencji modelu.
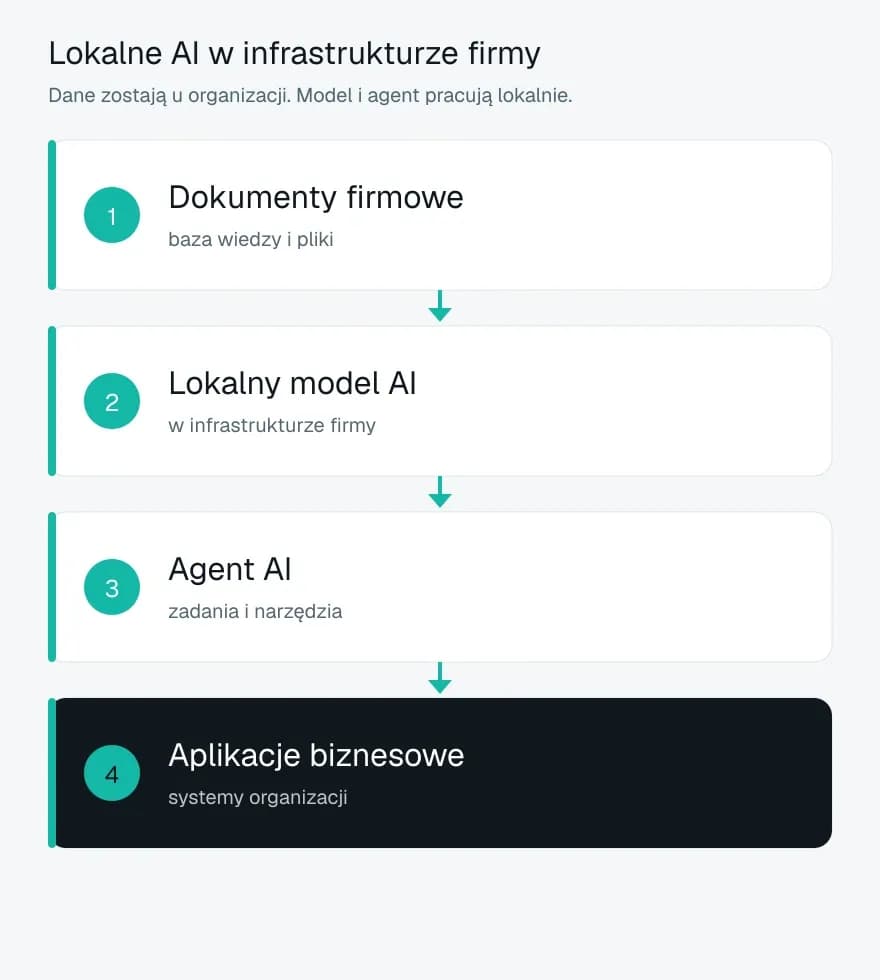
Schemat poglądowy: dokumenty firmowe trafiają do lokalnego modelu, agent realizuje zadanie, a wynik wraca do aplikacji biznesowych.
Alterkom – infrastruktura dla lokalnego AI
Alterkom rozwija rozwiązania, które pozwalają używać sztucznej inteligencji w infrastrukturze przedsiębiorstwa. Łącząc odpowiedni sprzęt, modele językowe i oprogramowanie integracyjne, można budować środowisko dopasowane do organizacji — od pojedynczego serwera po rozbudowane systemy agentowe.
Chcesz uruchomić AI we własnej firmie? Skontaktuj się z Alterkom i poznaj możliwości lokalnych rozwiązań AI.
Źródła
Poniższe odnośniki prowadzą do dokumentacji konkretnych modeli i do opisu DGX Spark. Parametry wdrożenia należy czytać z aktualnej karty, nie z podsumowania.
NVIDIA Blog — Nemotron 3.5 Super VL i Bolt (15 października 2026)
NVIDIA Technical Blog — Nemotron 3.5 Super VL
Karta modelu — Nemotron 3.5 Super VL 120B-A12B BF16
Karta modelu — Nemotron 3.5 Super VL 120B-A12B NVFP4 (m.in. DGX Spark)
Karta modelu — Nemotron 3.5 Bolt 74B-A9B 24GB
Raport techniczny — Nemotron 3.5 Bolt 74B-A9B 24GB
Karta modelu — Nemotron 3.5 Bolt E4B 4GB
NVIDIA Research — Nemotron 3.5 Bolt E4B 4GB (23 października 2026)
Planujesz bezpiecznych agentów AI w swojej organizacji?
Porozmawiaj z Alterkom o lokalnych modelach LLM, kontroli dostępu i infrastrukturze dla firmowych agentów AI.